
网页转 PDF 如何实现?聊聊打印、整页截图和浏览器自动化
从浏览器打印、HTML 转 PDF 和整页截图讲起,对比常见实现方案,说明 Webpage to PDF 的分块截图、PDF 生成流程,以及扩展 debugger 提示的原因。
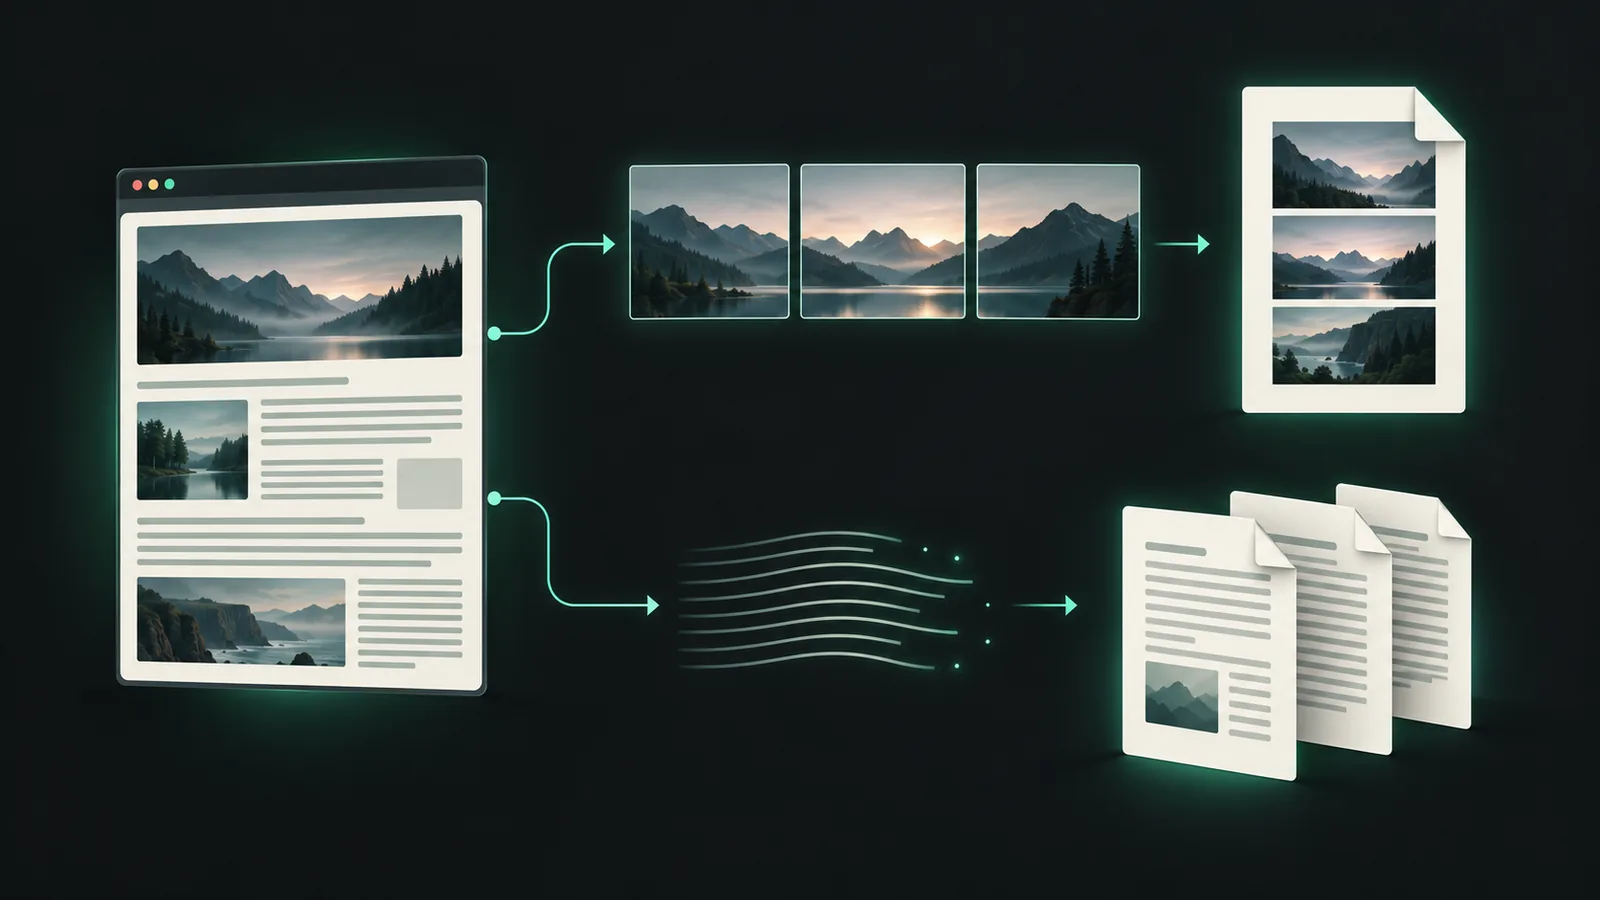
网页转 PDF 理论上很简单:打开网址,等页面加载完,保存一下就行了。浏览器本身也有打印功能,理论上只要调用一下现成的接口,应该没什么难度。
但是这里面可能有很多细节上的问题:打印出来的页面为什么和屏幕上不一样?截图明明有文字,放进 PDF 后为什么不能复制?网页很长的时候,为什么后半部分会缺失?这些情况不一定会一起出现,但是不同的场景下,可能会有不同的表现。
网页转 PDF 这个功能实际上有多少实现方案,下面简单的介绍一下市面上的网页转 PDF 的基本原理,再介绍一下 Webpage to PDF 目前的处理流程。至于扩展为什么会在浏览器顶部显示 debugger 提示,以及为什么不建议直接关闭它,后面也会说明。
1. 直接使用浏览器打印
这是最容易想到的方案。打开网页,按下打印快捷键,把目标打印机改成“另存为 PDF”,浏览器就会生成文件。普通文字通常可以选中,链接也可能保留下来,偶尔保存一篇文章,用这个办法就够了。
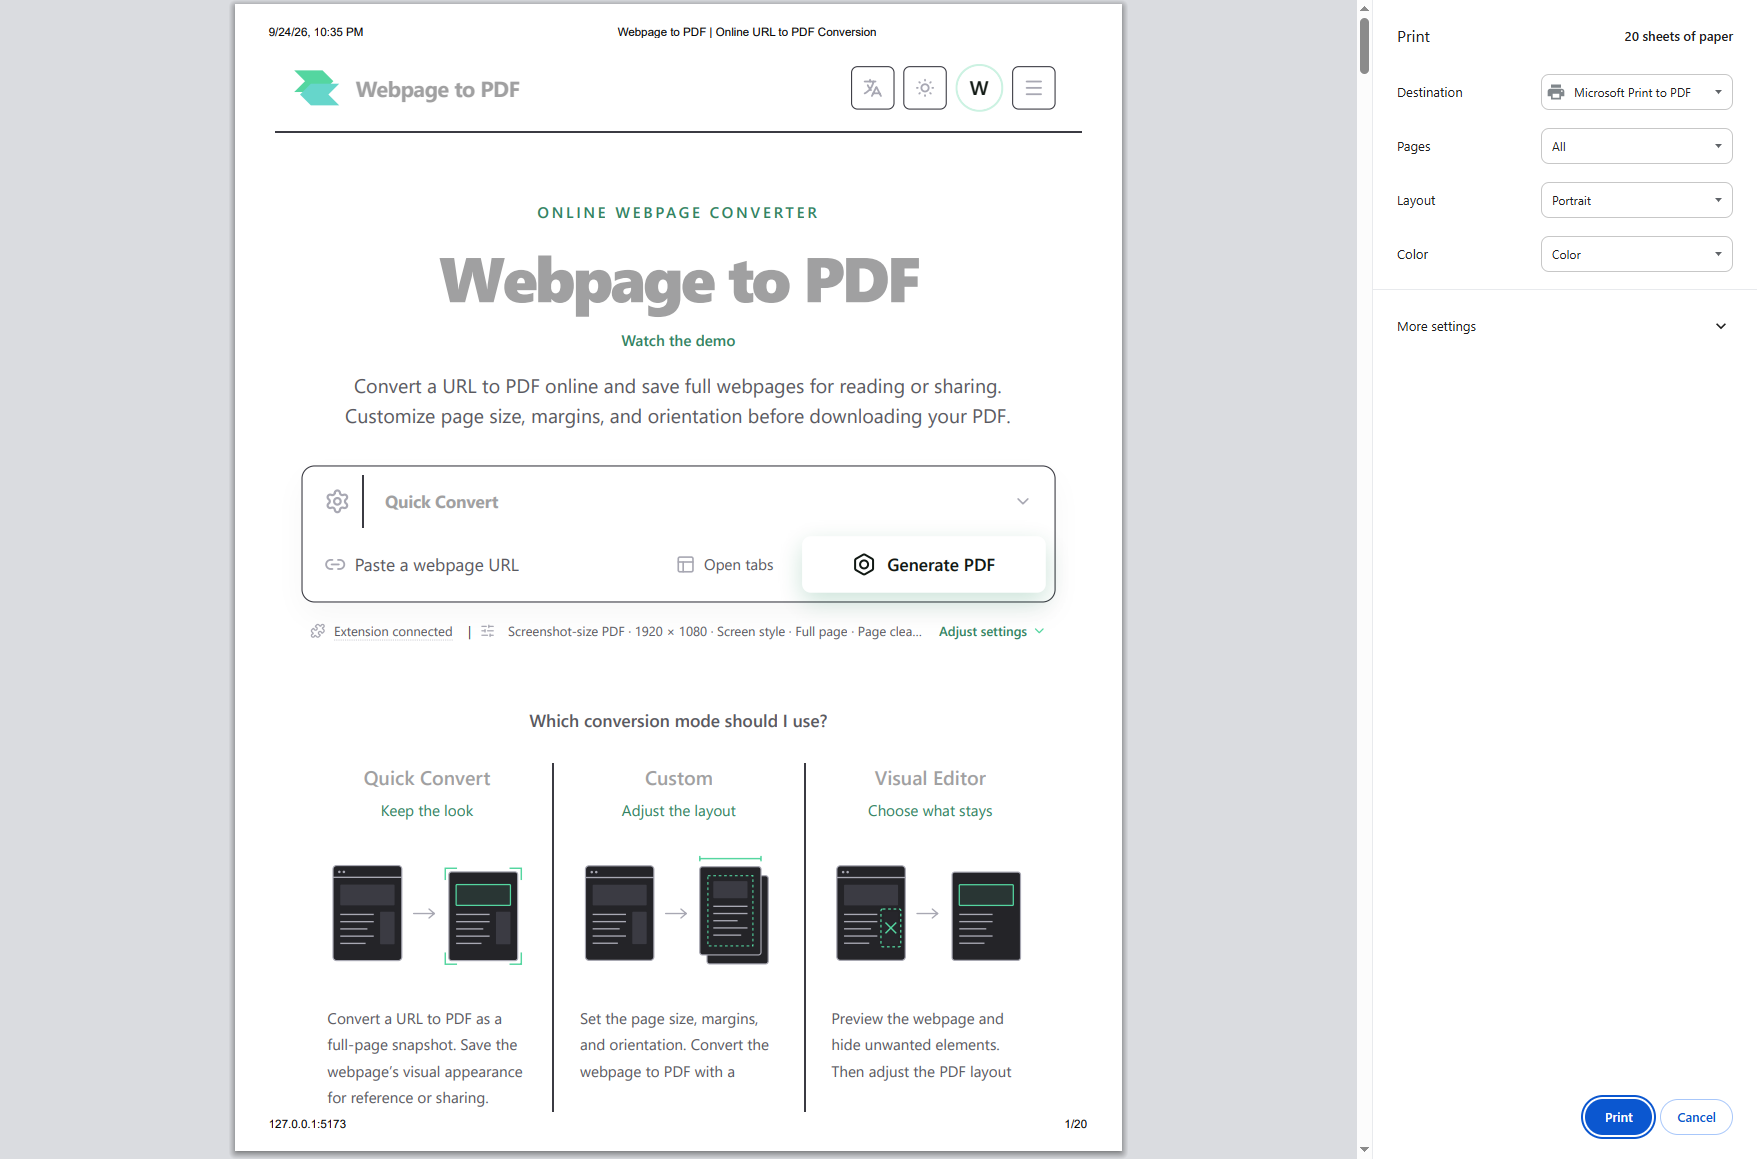
问题在于,网站的样式是否支持打印模式,有一些网站会对打印模式进行特殊的样式处理,导致打印出来的页面和屏幕上不一样。例如隐藏导航和广告,把深色背景换成白色,或者重新调整正文宽度。这些修改在阅读时可能更合适,但是在打印时,可能会导致页面布局和内容不一致。
还有一种情况比较容易误判:网站的主要样式只对 screen 生效,切换成 print 后,大部分样式都不再匹配,看起来像 CSS 没加载。其实文件可能已经下载了,只是当前不使用这些规则。具体可以参考 MDN 的打印样式说明。
当然,也可以让 PDF 输出使用 screen 样式,不过纸张宽度、边距和分页仍然存在。一个连续的网页放到 A4 纸上,总要决定在哪里换页,不能指望换个媒体类型就解决所有排版问题。
2. HTML 转图片,再把图片写入 PDF
这类方案经常会用到 html2canvas。名字里带着 canvas,很容易让人以为它就是给浏览器截个图,实际上不是这么回事。
它读取 DOM 和样式,再根据自己支持的绘制规则重建画面。换句话说,浏览器已经画过一遍了,这个库还要再画一遍。自己控制的组件和简单报表比较容易处理,换成任意网站,CSS 支持范围、跨域图片和 Canvas 尺寸限制都需要考虑。官方文档也明确说明了它和真实截图的区别。
另一种做法是直接让浏览器截图,再把截图写入 PDF。这样拿到的是浏览器实际渲染的画面,保存网页外观会更直接。不过这两种方法生成的都是图片型 PDF,生成的 PDF 中的文字无法被选中和复制,这一点需要注意。
目前 webpage to pdf 的 Quick 模式的实现方案中,都是通过浏览器截图,再把截图写入 PDF。这种模式的好处就是保留了网页的实际渲染效果,可以连续显示,但是长页面需要分块截图,否则单张图片的尺寸和内存占用都会成为问题。
3. 自动化浏览器和专用排版引擎
如果要做在线 URL 转 PDF 服务,不能每次都让人打开打印窗口。因此可以通过 Puppeteer 这类工具控制浏览器,设置页面尺寸、等待加载,然后调用截图或 PDF 接口。Webpage to PDF 的云端转换也需要这样的浏览器处理过程。Puppeteer 的 PDF 接口本质上仍然使用浏览器的打印能力。
自动化解决了重复操作的问题,但什么时候算加载完成,还是需要自己决定。有些网站一直在发统计请求,有些图片滚动到附近才加载,还有些弹窗要过一会儿才出现。一直等,任务可能永远不结束;完全不等,内容又可能不全。
除此之外,也有专门的 HTML 转 PDF 或文档排版引擎。固定模板的发票、账单、报表比较适合这类方案,因为输入内容和样式都可控。不过不同引擎对 CSS 和 JavaScript 的支持有差异,不能直接认为它能完整运行任意网站。
把前面几种方案放在一起,大致可以这样比较:
| 方案 | 优点 | 需要注意的地方 | 适用场景 |
|---|---|---|---|
| 浏览器打印 | 无需额外工具,通常保留文字和链接 | 打印样式和分页可能改变布局 | 偶尔保存文章、打印网页 |
| DOM 转 Canvas | 可以在网页脚本中执行,方便导出自己的组件 | 需要重建样式,受跨域资源和画布尺寸限制 | 简单报表、固定组件 |
| 浏览器整页截图转 PDF | 保留实际渲染的外观,可以连续显示 | 文字是图片,长页面需要分块 | 设计参考、页面存档 |
| 自动化浏览器输出 PDF | 可重复执行,可以控制打印参数 | 需要处理加载、登录状态和浏览器资源释放 | 在线 URL 转 PDF 服务 |
| 专用排版引擎 | 固定模板和分页便于控制 | 任意网站的 CSS、JavaScript 未必受支持 | 发票、账单、模板文档 |
这里的分类不是互斥的。自动化浏览器既可以打印,也可以截图;浏览器扩展同样可以完成这两件事。最终是图片 PDF 还是文字文档,要看实际调用了哪条流程。
4. Webpage to PDF 的核心
目前 webpagetopdf 有云端和扩展本地两种网页浏览方案。
云端收到网址后,由网站后端校验请求、协调任务,再交给浏览器服务打开页面。这个浏览器不在你的电脑上,也不会自动继承你当前的登录状态。所以同一个地址,你这里能看到内容,云端却显示登录页,并不奇怪。
扩展本地转换使用你选中的标签页,在权限和页面类型允许的范围内处理当前网页。页面已经登录、已经展开了某些内容,这些状态就可以作为转换的起点,不需要远程浏览器重新打开一遍。本地渲染无需把页面交给云端浏览器,不过账户等功能仍有各自的网络请求,不能把它理解成整个扩展完全离线。
扩展通过 chrome.debugger 发送 Chrome DevTools Protocol,也就是 CDP 命令,控制视口(viewport)、screen 或 print 模式、截图和 PDF 输出。顶部那个 debugger 提示就来自这里。

5. Quick 模式为什么要分块截图?
Quick 的目标是尽量保留整个网页的外观,最后生成一页连续的 PDF。短页面截一张图即可,但网页足够长的时候,单张图片的尺寸和内存占用都会成为问题。继续强行截图,可能出现缺失、重复或者空白,不能只看接口有没有返回成功。
因此目前的做法是先测量文档,再按区域截取多张图片。每张图片除了内容,还带着它在页面中的位置和尺寸。生成 PDF 时,直接把这些片段放到对应位置,不再合成一张超长图片,否则绕了一圈,又回到了原来的限制上。
例如,假设一个页面分成三段,第二段在原网页中从某个纵坐标开始,那么放进 PDF 后也应该接在第一段后面。分成三张图片,不代表要生成三页 PDF。
PDF 页面本身也不能不考虑尺寸。当前实现采用 14,400 点的页面尺寸上限;宽或高超过这个上限时,整页按同一个比例缩小,所有图片的位置和尺寸一起缩放。只缩高度、不缩宽度,页面就会被压扁。这里说的是当前实现选择的兼容性上限,并不是所有 PDF 规范和阅读器都只有这个限制。
分块也不是万能的。网站如果使用虚拟列表,把屏幕外的 DOM 删除了,或者截图期间内容一直变化,仍然可能影响结果。它解决的是单张截图过大的问题,不是让网页和内存都变得无限大。
6. Custom 和 Visual 如何生成 PDF?
Custom 同样会截图,但截图只是预览。最终文件由浏览器打印生成:扩展使用 Page.printToPDF,云端通过 Puppeteer 调用浏览器的 PDF 输出,随后再处理支持的文档选项。
这点很容易混淆。Custom 的长页面预览可以拆成多张图片,不代表最终 PDF 也要改成图片拼接。普通网页文字通常可以保留为文字,纸张和分页交给浏览器处理;原本就在图片或 Canvas 里的字,当然不会自动变成可复制的文本。
Visual 则在导出前多了编辑过程。先应用转换需要的视口和渲染模式,再隐藏节点、修改样式,最后对编辑后的网页输出 PDF。本地扩展直接编辑真实页面,网站编辑器则操作远程网页,通过截图和 DOM 信息展示结果。
网站上的预览即使由多张图片拼接,DOM 坐标仍然属于整个网页。点击选择元素时,要把鼠标位置结合容器的缩放和滚动换算回页面坐标,不能到了第二张图片就把纵坐标重新从零开始计算。
扩展还支持导出选中的节点。这里会把编辑后的选中内容作为独立文档的根来准备,而不只是从截图里裁下一块。脱离原来的父级后,某些样式和宽度可能发生变化,所以这种结果需要按独立页面来检查。
7. 从打开网页到下载 PDF 文件,中间执行了什么步骤?
前面讲的是原理,实际运行还要把加载和还原串起来。大致流程如下:
- 打开或获取网页。云端打开页面和等待资源共用一个超时时间:页面没有打开就报错;页面已经打开,只是资源迟迟没有稳定下来,到达时间上限后可以继续。用户配置的额外等待时间另算。
- 应用页面设置。包括视口、渲染模式,以及配置要求的配色、动画、等待、懒加载预加载和页面清理。清理按规则识别,不能保证覆盖所有网站的弹窗。
- 截取预览。测量处理后的网页,返回带坐标的图片片段。Quick 也使用这些图片生成最终文件。
- 生成源 PDF。Custom 和 Visual 调用浏览器打印,获得后续处理需要的 PDF。
- 还原和释放。扩展尝试恢复临时修改并断开调试连接,云端释放远程浏览器资源。
- 完成 PDF 处理。Quick 把图片放到同一页,其它模式处理源 PDF 的相关设置,再展示结果供下载。
如果中间出错,正常流程会停止,并有错误提示。内部则会尝试清理现场,不能因为截图失败,就把改过的显示设置留给用户。这里的异常清理和正常流程不是一回事,不能清理成功了,就把后面没有执行的步骤也显示成完成状态。
8. 为什么不要直接关闭顶部的 debugger 提示?
使用扩展本地转换时,浏览器顶部会出现正在调试的提示。这是 Chrome 告知你,扩展正在通过调试连接操作当前标签页,不需要你再打开开发者工具。具体接口可以看 Chrome debugger 文档。
问题出在横幅上的 Cancel。点击它,会由浏览器直接断开连接。如果此时正在截图或者修改显示参数,命令可能执行到一半就被打断,扩展也就不能按原来的顺序完成还原。
测试中确实出现过这种情况:中断截图后,页面尺寸异常,或者滚动条消失,刷新同一个标签页也没有恢复。至于是否每次都会发生,还与浏览器版本和中断时机有关,不能简单说点击取消就一定会出问题。
所以,如果需要停止转换,请使用侧边栏里的“取消”,让扩展有机会停止任务并执行清理。浏览器还在处理时,先保留顶部提示。加这个提醒并不代表底层问题已经彻底修好,也不能保证所有异常都能自动还原。
如果已经遇到了显示异常,可以在扩展出现“Restore page display(还原页面显示)”时点击还原。仍然无效的话,先在新标签页打开同一个网址,确认显示正常后再关闭旧标签页。新标签页有自己的显示状态,不过旧页面未保存的表单输入不会跟过去,这一点要注意。
只需要把网页保存为 PDF,不必把这些接口都研究一遍。保留原始外观用 Quick,需要纸张排版和文字选择用 Custom,要先修改内容再用 Visual。如果结果不符合预期,先分清是网页没有加载完整、截图出了问题,还是打印样式改变了布局,再调整对应设置,会比反复点击转换更有用。